常见故障处理模型 常见故障处理模型包括
-
常见,故障,处理,模型,包括,在,数字化,浪潮,

- 人际关系-自由百科知识生网
- 2026-11-06 01:46
- 自由百科知识网
常见故障处理模型 常见故障处理模型包括 ,对于想学习百科知识的朋友们来说,常见故障处理模型 常见故障处理模型包括是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在数字化浪潮席卷一切的今天,无论是复杂的IT系统、精密的工业生产线,还是我们日常依赖的智能设备,“故障”如同幽灵,总在不经意间现身。面对突发状况,是手忙脚乱、疲于奔命,还是从容不迫、高效化解?这其中的天壤之别,往往取决于是否掌握了一套科学、系统的常见故障处理模型。这些模型并非僵化的教条,而是凝聚了无数实践智慧的思维框架与行动指南,它们像一幅精密的地图,引导我们穿越问题的迷雾,直抵解决的彼岸。本文将为您揭开这些核心模型的神秘面纱,深入剖析其精髓与应用,助您在面对任何故障时都能胸有成竹,游刃有余。
一、经典五步法:故障处理的基石
谈及故障处理,最广为人知且历久弥坚的模型莫过于“五步法”。这是一个逻辑严密、普适性极强的通用框架,构成了应急响应的核心骨骼。
第一步是识别与定义故障。这远不止于发现问题本身,更在于精准界定问题的边界、影响范围和严重等级。一个优秀的工程师在此阶段会像侦探一样,收集所有异常现象、错误日志和用户反馈,用清晰的语言描述“发生了什么”以及“什么情况下发生”,为后续步骤奠定坚实的事实基础。
紧接着是隔离与遏制影响。在故障如野火般蔓延前,必须迅速建立“防火墙”。这可能意味着将故障模块从系统中剥离,切换到备用链路,或者实施流量降级。其核心目标是阻止局部问题演变为全局性灾难,将损失控制在最小范围内,为根治问题赢得宝贵时间。
随后进入根因分析与定位阶段。这是整个处理过程的技术核心,需要运用鱼骨图、5Why分析法等工具,像外科手术般层层剥离表象,直指问题根源。是代码缺陷、配置错误、硬件老化,还是资源瓶颈?精准的定位是有效修复的前提。
二、PDCA循环:持续改进的引擎
如果说五步法专注于解决单次故障,那么PDCA循环(计划-执行-检查-处理)则着眼于构建长效的故障防御与改进机制。它将故障处理从被动响应提升至主动管理的维度。
计划阶段着眼于未雨绸缪。基于历史故障数据和系统风险评估,制定详尽的应急预案、巡检清单和升级流程。这个阶段的核心是提出问题:“如果……发生,我们该如何应对?”通过事先的推演和准备,大幅提升团队的应急反应速度与准确性。
执行与检查阶段密不可分。当按照计划进行故障处理或演练后,必须严格检查结果:处理时间是否达标?解决方案是否彻底?监控指标是否恢复正常?这一阶段需要客观的数据和严谨的复盘,而非模糊的感觉判断。
最后的处理阶段是升华的关键。将检查中获得的经验教训进行标准化:固化有效的解决方案为知识库条目,修改有缺陷的流程,并将未解决的遗留问题转入下一个PDCA循环。如此周而复始,让每一次故障都成为系统变得更健壮的契机。
三、分层诊断模型:化繁为简的利器
面对复杂系统,故障可能隐藏在应用层、中间件、操作系统、网络或硬件等任何一层。分层诊断模型提供了自上而下或自下而上的清晰排查路径,有效避免了“大海捞针”式的盲目。
自上而下排查从用户可直接感知的应用层开始。先检查前端界面、API响应和业务逻辑,逐步向下穿透,经过服务层、数据层,最终抵达基础设施层。这种方法路径直接,尤其适合快速定位与特定业务功能相关的问题。
自下而上排查则从物理硬件和网络连通性等基础层开始验证。先确保服务器电源、网络链路、存储磁盘这些基石稳固,再逐步向上检查操作系统、依赖服务,最后到应用本身。这种方法适用于系统完全不可用或怀疑底层基础设施出现问题时。
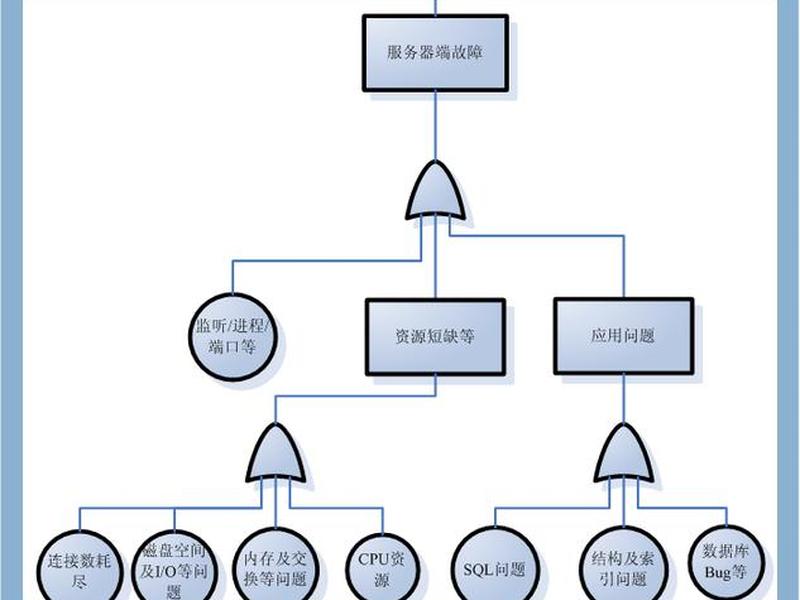
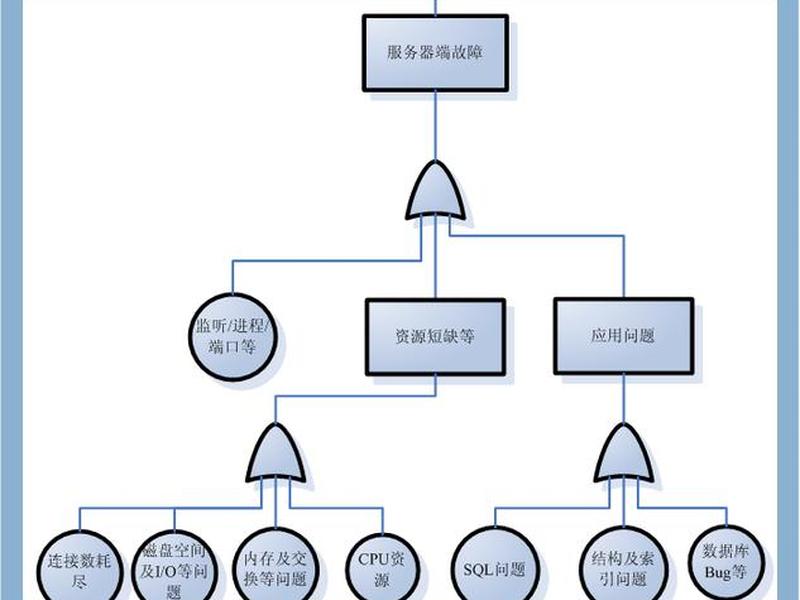
在实际运用中,混合式排查往往效率更高。根据故障现象的特征,智能地选择在某一层切入,然后向关联层扩散。例如,若数据库访问缓慢,可同时检查网络延迟(下层)和SQL语句性能(上层)。熟练掌握分层思想,能大幅缩小排查范围。
四、事前防控体系:防患于未然的智慧
最高明的故障处理,是让故障根本不发生,或在其萌芽状态即被消灭。这依赖于构建强大的事前防控体系,将防线大幅前移。
监控与预警系统是这座防线的“眼睛”和“耳朵”。通过建立覆盖全链路的关键指标监控(如CPU、内存、错误率、响应时间),并设置合理的预警阈值,可以在性能劣化或异常刚露头时就触发告警。智能的预警甚至能基于趋势预测潜在故障,实现从“救火”到“防火”的转变。
混沌工程与韧性测试则是主动“攻击”自己系统的艺术。通过在生产环境中模拟服务器宕机、网络延迟、依赖服务失效等场景,主动发现系统的脆弱点。这种在可控范围内故意制造的“故障”,能暴露出在平稳运行中永远无法发现的隐患,从而有针对性地加固系统架构。
容量规划与资源管理也至关重要。定期评估业务增长与资源消耗的关系,提前进行扩容或优化,避免因资源耗尽导致的系统性故障。建立完善的变更管理和灰度发布流程,确保任何对系统的修改都是可控、可观测、可回滚的。
五、组织与流程保障:人为因素的决胜点
再完美的技术模型,也需要人的有效执行。故障处理不仅是技术活动,更是组织行为。建立清晰的组织与流程保障,是模型能否落地的关键。
明确角色与职责分工是高效协作的基础。在应急响应中,谁是指挥官?谁是技术主攻?谁是对外沟通接口?事先定义好的角色(如基于ITIL的故障经理、技术支持小组)能避免混乱,确保指令畅通,人尽其责。定期的演练能让团队磨合熟练,形成肌肉记忆。
标准化沟通与上报流程同样生死攸关。包括内部技术沟通的频道与话术,以及向管理层、业务方和用户通报的时机、口径与渠道。透明、及时、准确的沟通能有效管理预期,凝聚合力,避免误解和次生危机。
建立无责复盘文化是组织成长的核心。故障复盘会的目的不是追究个人责任,而是共同探究技术根因和流程改进点。营造安全、开放的讨论氛围,鼓励分享教训而非隐瞒失误,才能打破“重复犯错”的循环,真正实现组织能力的迭代进化。
六、知识沉淀与赋能:从经验到资产的蜕变
故障处理过程中产生的知识和解决方案,是组织最宝贵的资产之一。建立有效的知识沉淀与赋能机制,能让个人经验转化为团队乃至整个组织的集体智慧。
构建动态知识库是首要任务。这个知识库不应是静态的文档堆积,而应与故障工单系统、监控工具联动,能够根据故障现象智能推荐相关案例和解决方案。每解决一个新故障,其处理过程、根因分析和最终方案都应及时沉淀为结构化案例,方便后续检索。
设计场景化演练与培训至关重要。利用沉淀的经典故障案例,设计模拟演练场景,让团队成员,特别是新人,在安全环境中体验真实故障的压力和决策过程。这种“实战化”培训远比阅读文档有效,能快速提升整体团队的故障应对能力。
推动工具化与自动化是终极方向。将那些重复性高、步骤固定的诊断动作和修复操作,封装成诊断脚本或自动化修复工具。当类似故障再次发生时,系统可以自动执行初步诊断甚至自愈,将工程师从重复劳动中解放出来,专注于更复杂、更有创造性的问题。
以上是关于常见故障处理模型 常见故障处理模型包括的介绍,希望对想学习百科知识的朋友们有所帮助。
本文标题:常见故障处理模型 常见故障处理模型包括;本文链接:https://yszs.weipeng.cc/rj/960059.html。
猜你喜欢
- 常见的人机交互方式,常见的人机交互方式有哪些?或者交互方式的发展过程? 2026-11-06
- 常见困扰的人际现象;常见困扰的人际现象重复发生的原因有人际技巧可能无效 2026-11-06
- 常见困扰的人际现象重复发生的原因?()、常见困扰的人际现象重复发生的原因有人际技巧可能无效 2026-11-06
- 常见困扰人际关系重复发生的原因 常见困扰人际关系重复发生的原因是 2026-11-06
- 常见人际关系问题、常见人际关系问题与方法ai 2026-11-06
- 常见人际关系误解 - 常见人际关系误解案例 2026-11-06
- 常见人际关系词汇解析;常见人际关系词汇解析大全 2026-11-06
- 常见人际关系英文词汇学习 人际关系英语词汇 2026-11-06
- 常见人际关系英文单词学习、人际关系英文单词怎么写 2026-11-06
- 常见人际关系类型有哪些,人际关系的类型有哪些 2026-11-06