反向计分的量表怎么分析信效度 量表中反向计分怎么分析
-
反向,计分,的,量表,怎么,分析,信效度,量,表中,

- 人际关系-自由百科知识生网
- 2026-10-24 16:16
- 自由百科知识网
反向计分的量表怎么分析信效度 量表中反向计分怎么分析 ,对于想学习百科知识的朋友们来说,反向计分的量表怎么分析信效度 量表中反向计分怎么分析是一个非常想了解的问题,下面小编就带领大家看看这个问题。
你是否曾对着一份含有反向计分题的量表数据感到困惑?明明收集了宝贵数据,却在信效度分析时遭遇“滑铁卢”——信度系数低得离谱,甚至出现负值;因子分析结果混乱,题项“跑”到了不该去的维度。这很可能是因为,你在分析前遗漏了一个至关重要的步骤:反向计分处理。反向计分题就像隐藏在问卷中的“暗雷”,处理得当,它能有效检验受访者是否认真作答,提升数据质量;处理不当,则会直接扭曲分析结果,让整个研究功亏一篑。本文将为你揭开反向计分量表信效度分析的神秘面纱,提供从理论到实操的完整攻略。
反向计分:数据处理的“临门一脚”
在进行任何信效度分析之前,数据预处理是基石,而对反向计分题的处理则是这块基石上最关键的一步。反向计分题的设计初衷,是为了打破受访者的思维定势和惯性作答,迫使其仔细阅读题目。例如,在测量“工作满意度”的量表中,大部分题目是正向表述(如“我对目前的工作感到满意”),但会穿插少数反向表述的题目(如“我常常想换一份工作”)。在计分时,正向题可能“非常同意”计5分,“非常不同意”计1分;而反向题则需颠倒过来,“非常同意”计1分,“非常不同意”计5分。
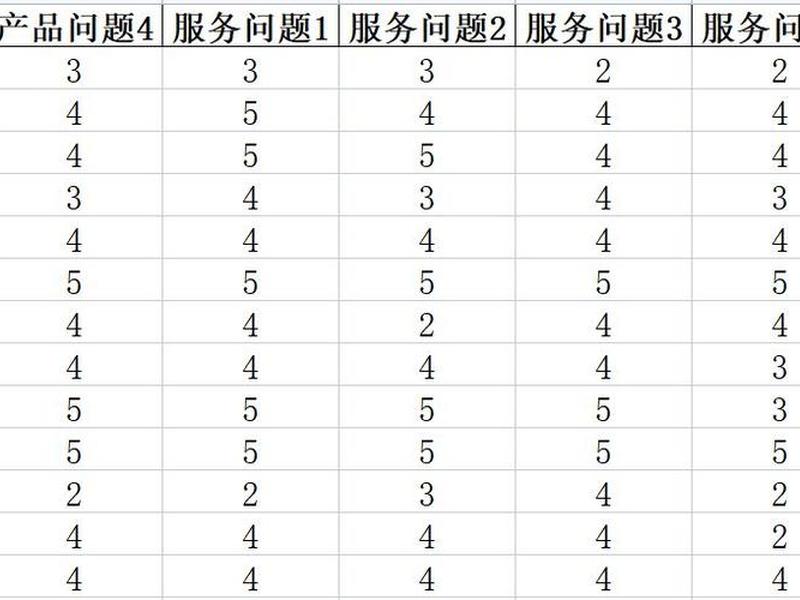
如果在分析前不进行反向转换,这些题目的得分方向就与其他题目相反。计算总分或均值时,高低分所代表的含义将产生矛盾,严重破坏量表内部的一致性。这直接导致信度分析中的克隆巴赫α系数异常偏低甚至为负值。识别并转换反向计分题,是确保所有题目得分方向统一、使“得分越高代表程度越高”这一解释成立的前提。这一步骤通常在数据清洗阶段,借助SPSS、SPSSAU等工具的“数据编码”或“重新编码”功能完成,将原始得分(如1,2,3,4,5)系统地转换为(5,4,3,2,1)。
信度分析:筑起可靠性的城墙
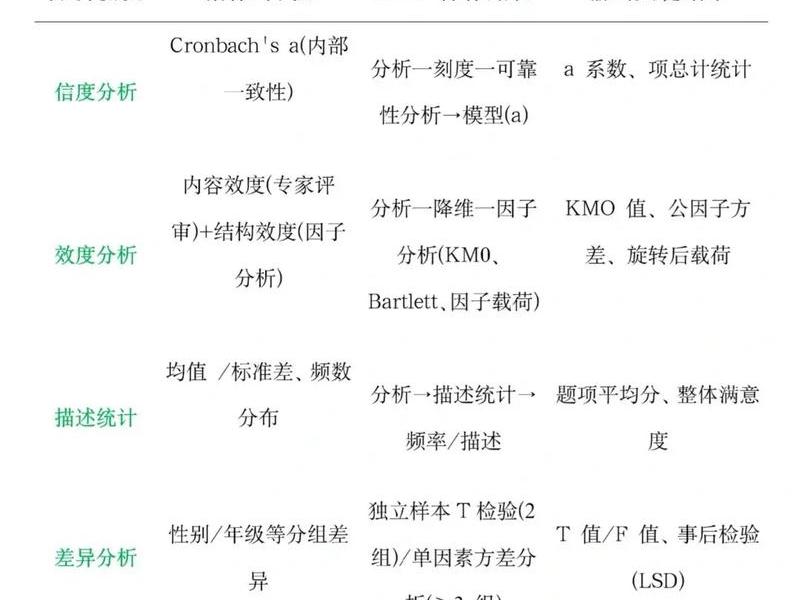
完成反向计分处理后,便可着手进行信度分析,它是检验量表稳定性和一致性的核心指标。对于包含反向题的量表,信度分析的目标是评估所有题目(包括已转换的反向题)是否在测量同一个构念。最常用的指标是克隆巴赫α系数,它衡量的是量表内部题目之间的相关性。
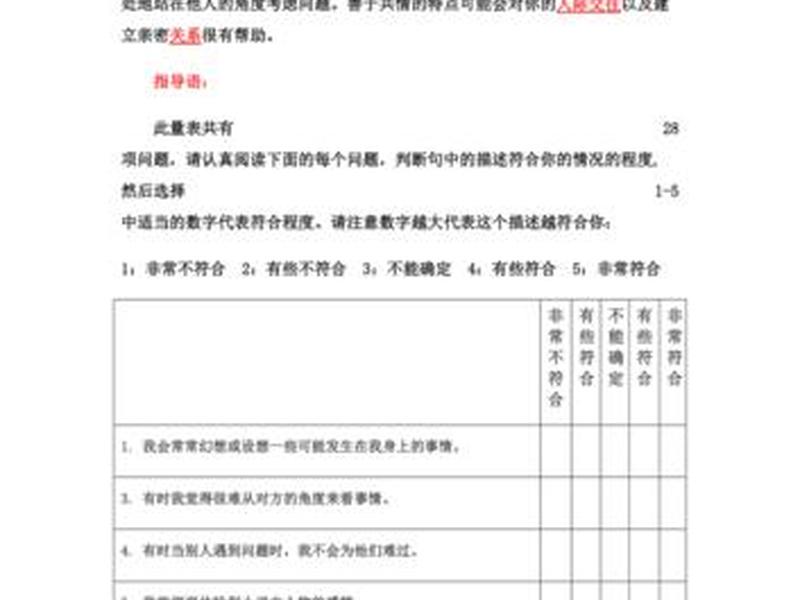
若反向题未处理,这些“唱反调”的题目会显著拉低题目间的平均相关性,导致α系数偏低。一个经过妥善处理的量表,其整体α系数通常应大于0.7,达到0.8以上则更为理想。分析时,除了关注整体信度,还应按维度分别计算信度。如果某个维度的α系数突然偏低,需要回头检查该维度内的反向题是否已正确转换,或是否存在表述不清、难以理解的题目。
有时,即使处理后信度仍不理想,可以进一步查看“校正项总计相关性”(CITC值)。若某题项的CITC值低于0.3,或“删除该项后的α系数”显著高于整体α系数,则考虑删除该题项以提升信度。但需谨慎,尤其是反向题,要确认其删除是否因设计本身不合理,而非转换错误。
效度分析:验证测量的精准度
效度关乎量表是否测量到了它真正想测的东西。对于含有反向计分量表的结构效度验证,探索性因子分析(EFA)和验证性因子分析(CFA)是两大主力工具。在进行因子分析前,通常先进行KMO检验和巴特利特球形检验,KMO值大于0.6且巴特利特检验显著,说明数据适合做因子分析。
在EFA中,反向题经过转换后,应与其理论归属的因子(维度)具有较高的因子载荷(通常绝对值大于0.5)。如果发现某道反向题在预期因子上的载荷很低,甚至跑到其他因子上,就需要反思:是题目表述存在歧义,还是反向计分的转换逻辑与受访者理解有偏差?结合因子载荷矩阵和碎石图,可以判断量表的因子结构是否与理论预设相符。
CFA则更进一步,用于检验预设因子模型的拟合优度。在模型中,反向题与其他题目一样,作为观测变量归属于特定的潜变量。分析结果会提供卡方自由度比、RMSEA、CFI、TLI等一系列拟合指标。良好的拟合度表明,包括反向题在内的所有题目都能很好地被理论结构所解释,量表具有较高的结构效度。通过计算平均方差抽取量(AVE)和组合信度(CR),可以进一步评估聚合效度。
结果解读:洞察数据背后的故事
分析完成后,如何解读这些数字背后的含义?一个健康的信度系数(如α>0.7)告诉你,这份量表是稳定可靠的,受访者的回答具有内部一致性,反向题的加入没有破坏这种一致性,反而可能因甄别了随意作答者而提升了数据纯度。
效度分析的结果则揭示了量表的“构造”是否坚固。成功的因子分析意味着,即使存在反向表述的题目,它们所测量的潜在特质依然能清晰地汇聚到预设的维度中。例如,在人格量表中,一道反向计分的情绪稳定性题目,最终仍会稳稳地落在“神经质”维度上,这强有力地证明了量表能够有效区分不同的心理构念。
更重要的是,通过对处理前后数据的对比,你能直观感受到反向计分处理的力量。处理前,相关矩阵可能一片混乱;处理后,题目间的逻辑关系变得清晰。这使得后续的所有统计分析,如差异检验、相关分析、回归模型,都建立在坚实、方向统一的数据基础之上。最终,你可以自信地得出结论:量表得分越高,代表所测特质(如满意度、焦虑水平、认同感)的程度越高,整个研究发现的解释力也因此大幅增强。
常见陷阱与规避策略
在实际操作中,研究者常会踏入一些陷阱。第一个陷阱是识别遗漏:在纷繁的题项中,未能准确识别出所有需要反向计分的题目。对策是在数据录入前就做好标记,或在问卷中明确提示受访者注意反向题。
第二个陷阱是转换错误:手动转换时出错,或在使用软件时设置错了新旧值的对应关系。例如,在5点量表中,误将“1转5,2转4,3转3,4转2,5转1”设置成“1转1,2转2...”,导致转换无效。务必在转换后,抽查几条数据,验证转换是否正确。
第三个陷阱是分析后忘记调整解释:所有题目方向统一后,对维度和总分高低分的解释需要保持一致。例如,原本反向题高分代表“不同意”,转换后高分就代表“同意”,在报告结果时,必须基于转换后的统一方向进行阐述,避免出现自相矛盾的解释。建立标准化的数据分析流程清单,能有效规避这些人为失误。
以上是关于反向计分的量表怎么分析信效度 量表中反向计分怎么分析的介绍,希望对想学习百科知识的朋友们有所帮助。
本文标题:反向计分的量表怎么分析信效度 量表中反向计分怎么分析;本文链接:https://yszs.weipeng.cc/rj/947911.html。
猜你喜欢
- 反噬在人际关系中的体现(反噬在人际关系中的体现有哪些) 2026-10-24
- 及时清理人际关系 - 及时清理人际关系的好处 2026-10-24
- 及时止损的人际关系准则 - 及时止损的人际关系准则有哪些 2026-10-24
- 参演欅坂46经历 - 欅坂46 blog 2026-10-24
- 参加人际关系训练营的感悟,参加人际关系训练营的感悟怎么写 2026-10-24
- 去除人际关系;去除人际关系的方法 2026-10-24
- 去重庆怎么样 - 去重庆怎么样报备 2026-10-24
- 去熟人公司打工的日子 - 去熟人公司打工的日子怎么样 2026-10-24
- 去熟人公司打工的利弊(去熟人公司打工的利弊是什么) 2026-10-24
- 去熟人公司上班的相处之道、去熟人公司上班的相处之道怎么说 2026-10-24