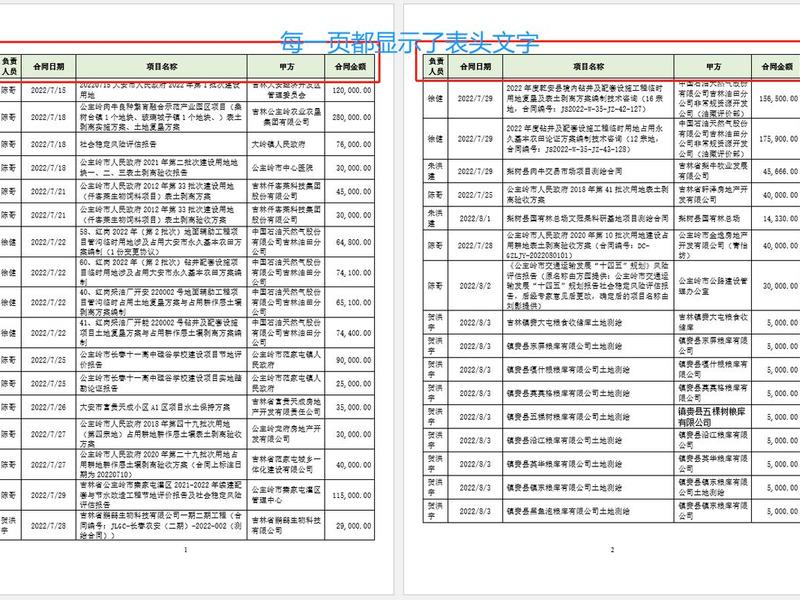
关系理论中二维表头;在关系理论中二维表的表头中各个栏目的名称被称为
-
关系,理论,中,二维,表头,在,表,的,头中,各个,

- 人际关系-自由百科知识生网
- 2026-10-20 18:10
- 自由百科知识网
关系理论中二维表头;在关系理论中二维表的表头中各个栏目的名称被称为 ,对于想学习百科知识的朋友们来说,关系理论中二维表头;在关系理论中二维表的表头中各个栏目的名称被称为是一个非常想了解的问题,下面小编就带领大家看看这个问题。
想象一下,一座宏伟数字图书馆的索引目录,每一个精准的分类标签,都决定了海量信息能否被瞬间定位与理解。在关系数据库的璀璨宇宙中,二维表的“表头”就扮演着这样至关重要的角色。表头中那一行定义清晰的名称,即各个“栏目”的名称,在关系理论中被称为“属性名”或“字段名”。它们绝非简单的标签,而是构建数据大厦的蓝图、确保信息血脉畅通的基因密码。本文将带您潜入关系理论的微观世界,以这些看似平凡的名称作为钥匙,开启一扇通往数据秩序、逻辑严谨性与无限应用潜能的大门。
定义基石:属性名的本质
在关系模型的严谨殿堂里,一张二维表被视作一个“关系”。表的每一列定义了一个“属性”,而该列最顶端的那个名称,便是“属性名”。它如同化学元素周期表中的符号“H”、“O”、“Fe”,是对一类数据本质特征的高度抽象与命名。例如,在“学生”表中,“学号”、“姓名”、“出生日期”便是不同的属性名。
属性名从根本上定义了该列数据的“语义”和“域”。所谓语义,指明了这列数据代表什么现实意义;所谓域,则规定了该列数据允许的取值范围和类型,是整数、文本还是日期。一个精心设计的属性名,如“会员注册时间戳”,其本身就蕴含了丰富的信息,远胜于一个模糊的“时间”。
属性名是关系模型逻辑结构的起点。它确保了数据在存入之初就被赋予了明确的身份和含义,避免了数据成为一堆无法解读的乱码。它是数据世界里的“第一推动力”,从命名开始,秩序便得以诞生。
设计艺术:命名的智慧与规范
为属性命名,是一门融合了清晰性、一致性与前瞻性的艺术。蹩脚的命名是未来数据灾难的温床。优秀的命名规则要求名称必须意义明确、避免歧义。例如,使用“产品单价_人民币”而非含糊的“价格”,能有效区分不同货币体系。
命名需保持风格一致。在整个数据库乃至系统中,遵循统一的命名规范(如全部使用英文小写加下划线,或采用驼峰命名法)至关重要。这不仅能提升可读性,更能为自动化工具的处理提供便利。想象一下,如果同一个概念在关联表中被命名为“user_id”、“UserID”和“UID”,将给数据连接带来多少混乱与额外成本。
好的属性名还应具备适度的稳定性和扩展性。它应能经受住业务微小演变而不频繁更改,因为改变一个核心属性名可能意味着需要修改所有相关的查询、应用程序代码和报表,代价高昂。一个名为“订单状态”的属性,其内涵可能从“未支付/已支付”扩展到包含“已发货/已收货/已评价”,只要名称本身能涵盖这些状态,它就具备了良好的扩展性。
核心纽带:连接数据的桥梁
属性名,特别是作为“主键”和“外键”的属性名,是维系整个关系数据库网状结构的核心纽带。主键属性(如“学号”)是表中每一行数据的唯一身份证,它保证了数据的实体完整性。而外键属性(如“学生表.班级编号”)则通过其名称,明确指向另一张表(班级表)的主键,从而建立了表与表之间的关联。
这种通过属性名建立的关联,是关系数据库实现“关系”的物理体现。它使得分散在不同表中的数据能够被重新组合与拼装,回答复杂的业务问题。例如,通过“员工表.部门ID”与“部门表.部门ID”的匹配,我们便能将员工归属到具体的部门。
这一特性彻底消除了数据冗余和信息孤岛。我们无需在“员工表”中重复存储部门的全部信息(如部门名称、经理),只需存储一个指向“部门表”的键(属性名)。这不仅节省了空间,更保证了数据的一致性——当部门名称变更时,只需在“部门表”中修改一处即可。
效能引擎:优化查询的密钥
在数据库查询的底层世界里,属性名是查询优化器工作的核心依据。当执行一条SQL语句(如`SELECT 姓名 FROM 学生 WHERE 学院=‘计算机学院’`)时,数据库系统需要快速定位到“姓名”和“学院”这两列数据所在的物理位置。
系统内部的数据字典(或元数据表)维护着属性名与物理存储结构之间的映射关系。清晰、规范的属性名有助于维护更高效的元数据,使得优化器能更快地解析查询意图。相反,冗长、怪异或经常变化的属性名会增加元数据管理的复杂度,间接影响解析效率。
更重要的是,基于属性名建立的索引,是加速查询的超级引擎。在“学院”属性上创建索引,相当于为这本数据字典建立了专门的快速检索目录,使得查找所有“计算机学院”学生的操作从逐行扫描变为快速定位,性能提升可达数量级之差。属性名,正是创建这把“加速钥匙”的指定标识。
应用之魂:驱动业务逻辑的齿轮
跳出技术范畴,属性名是业务逻辑在数字世界的直接投射。每一个属性名都对应着业务领域中的一个关键概念或度量指标。“库存数量”、“客户等级”、“订单折扣率”……这些名称本身就是业务术语。
在应用开发中,属性名直接映射到对象模型的属性或表单的字段。清晰准确的属性名能极大降低开发人员理解数据的成本,减少沟通误解,并自动生成更友好的用户界面标签。它们确保了从数据库设计、后端编码到前端展示,业务语义的一致性贯穿始终。
在商业智能和数据分析领域,属性名更是决定了报告的可读性和洞察的准确性。数据仓库中的维度与度量,其名称必须对业务用户直观易懂。一个名为“营收_月度环比增长率”的计算字段,比一个名为“ColC123”的字段,能让人瞬间理解其价值。好的属性名让数据自己会说话,成为决策者可信赖的伙伴。
演进前沿:挑战与未来
随着大数据、非结构化与半结构化数据的兴起,经典的二维表模型及其属性名体系也面临着新的挑战。在处理嵌套的JSON文档或图数据时,严格固定的表头结构有时显得僵化。动态schema、稀疏列等概念开始出现,允许更灵活地定义属性。
这并非属性名概念的消亡,而是其形态的演进。即使在NoSQL数据库中,用于标识数据字段的“键”依然承担着类似的角色。语义网、知识图谱等前沿领域强调的“本体”和“属性”,可以看作是在更广维度上对属性名及其关系的精密化与标准化,旨在让机器也能理解数据的含义。
未来,属性名或许将融入更多的元数据与上下文信息,变得更加智能和自我描述。但无论如何演进,其核心使命——为数据赋予准确、可理解的标识与含义——将永恒不变。它始终是连接现实世界与比特世界,沟通人类意图与机器执行的那座最基础的桥梁。
以上是关于关系理论中二维表头;在关系理论中二维表的表头中各个栏目的名称被称为的介绍,希望对想学习百科知识的朋友们有所帮助。
本文标题:关系理论中二维表头;在关系理论中二维表的表头中各个栏目的名称被称为;本文链接:https://yszs.weipeng.cc/rj/943963.html。
猜你喜欢
- 关系理论的经典实验,关系理论的经典实验有哪些 2026-10-20
- 关系特效(关系特性) 2026-10-20
- 关系特效可以换人吗;王者荣耀关系特效 2026-10-20
- 关系消防安全的绘画,关系消防安全的绘画怎么画 2026-10-20
- 关系洁癖是什么意思,关系洁癖是什么意思啊 2026-10-20
- 关系汉字的演变 - 关系汉字的演变教案 2026-10-20
- 关系比学历更重要(关系比学历更重要怎么说) 2026-10-20
- 关系模型基本结构是什么;关系模型基本结构是什么意思 2026-10-20
- 关系案例(关系案例范文) 2026-10-20
- 关系框架理论包括哪些部分(关系框架理论包括哪些部分内容) 2026-10-20